公告
Arion 0.1.1:第一个正式版本
Arion 0.1.1 今天发布,支持 Apple 芯片 Mac 和 Windows x64。语音听写、润色、翻译、离线拼音键盘和剪贴板历史都在你的电脑上运行,以 AGPL-3.0 协议开源。
Arion 0.1.1 今天发布,这是我们的第一个正式版本,支持 Apple 芯片 Mac(macOS 14 及以上)和 Windows x64,以 AGPL-3.0 协议开源,免费下载。
Arion 是本地优先的语音与拼音输入法。按住快捷键说话,无论是中文、英文还是同一句里中英混说,都在本机识别,松开后整句输入到光标位置。除了语音听写,它还带有可选的润色与语音翻译、离线全拼键盘,以及加密保存的剪贴板历史。
从第一个 alpha 到 0.1.1,我们发了 21 个预览版,和早期用户一起在日常使用的编辑器里打磨快捷键、候选框、润色规则和更新流程。这是我们推荐日常使用的第一个版本。
按住说话,松开上屏
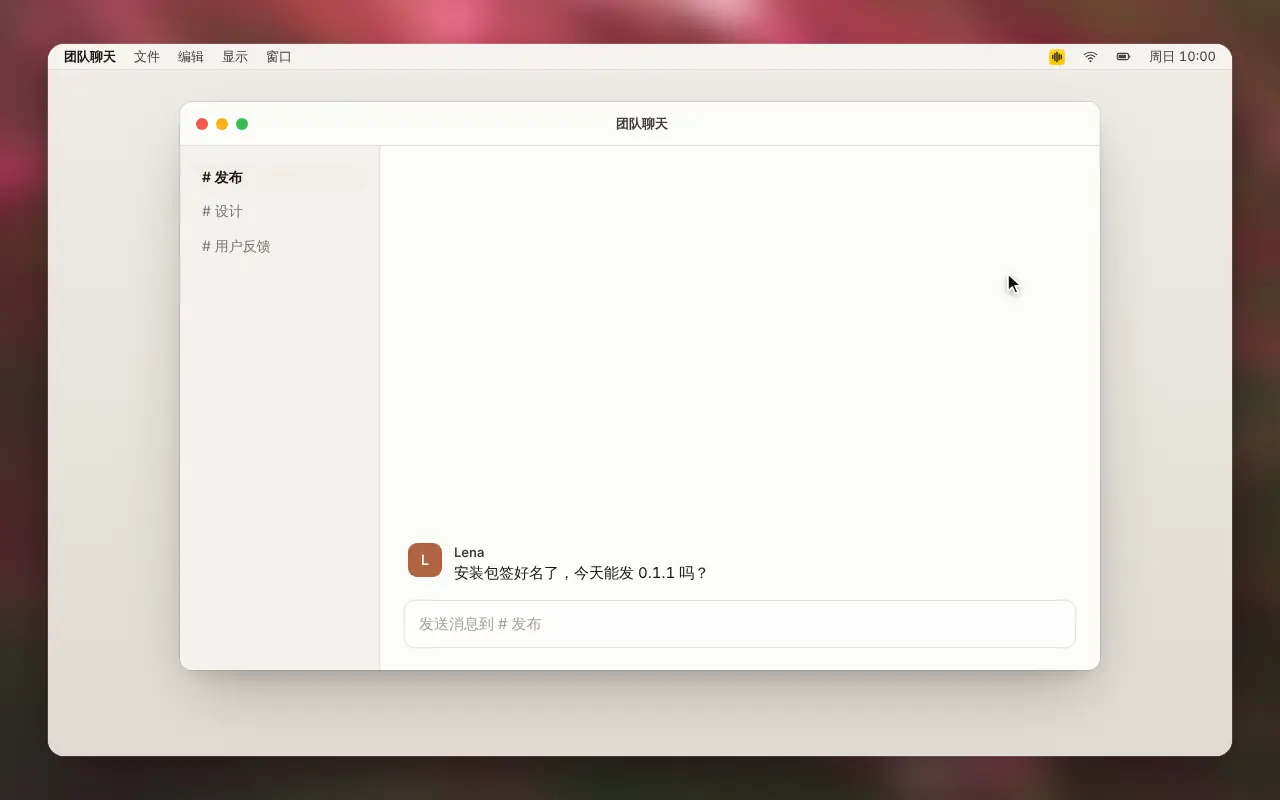
在任何能打字的地方,按住默认听写键(macOS 为右 Option,Windows 为右 Alt)说话,松手即上屏。轻按一下会切到免按住模式,持续收音直到你再次按键;中途按 Esc 可直接取消。你可以在设置里把听写键改成任意单键或组合键,录入时如果和翻译、剪贴板快捷键冲突,会当场提示。
说话时,流式识别的草稿留在屏幕下方的胶囊里,松开按键才一次性写入光标处。要是中途切换了窗口、移动了焦点或取消了听写,这次草稿会直接丢弃,避免误插到其他窗口。当前焦点不在输入框里时,结果会放进剪贴板,供你随时粘贴。
语音识别使用 Qwen3-ASR 1.7B,在 Apple 芯片上通过 MLX 以 8-bit 运行,在 Windows 上通过 speech.cpp 以 Q8_0 在 CPU 或 Vulkan 上运行。首次使用前下载一次模型(Mac 约 2.5 GB,Windows 约 2.2 GB),每个文件按固定的 SHA-256 摘要校验,之后听写全程离线。同一句话里中英混说,比如「把这个 PR merge 到 main 之前,先跑一下 CI」,无需事先切换语言。
在开放办公区小声说话时,可以在设置里把软件输入增益从 −6 dB 调到 +12 dB。遇到密码框,Arion 会跳过上下文读取,也不会从中学习。
说完再整理
润色默认关闭。开启后,松开听写键时本地语言模型会把这句话整理一遍:去掉「嗯」「那个」等语气词,处理说到一半的改口(如「周三,不对,周四」保留「周四」),并按当前应用调整格式。
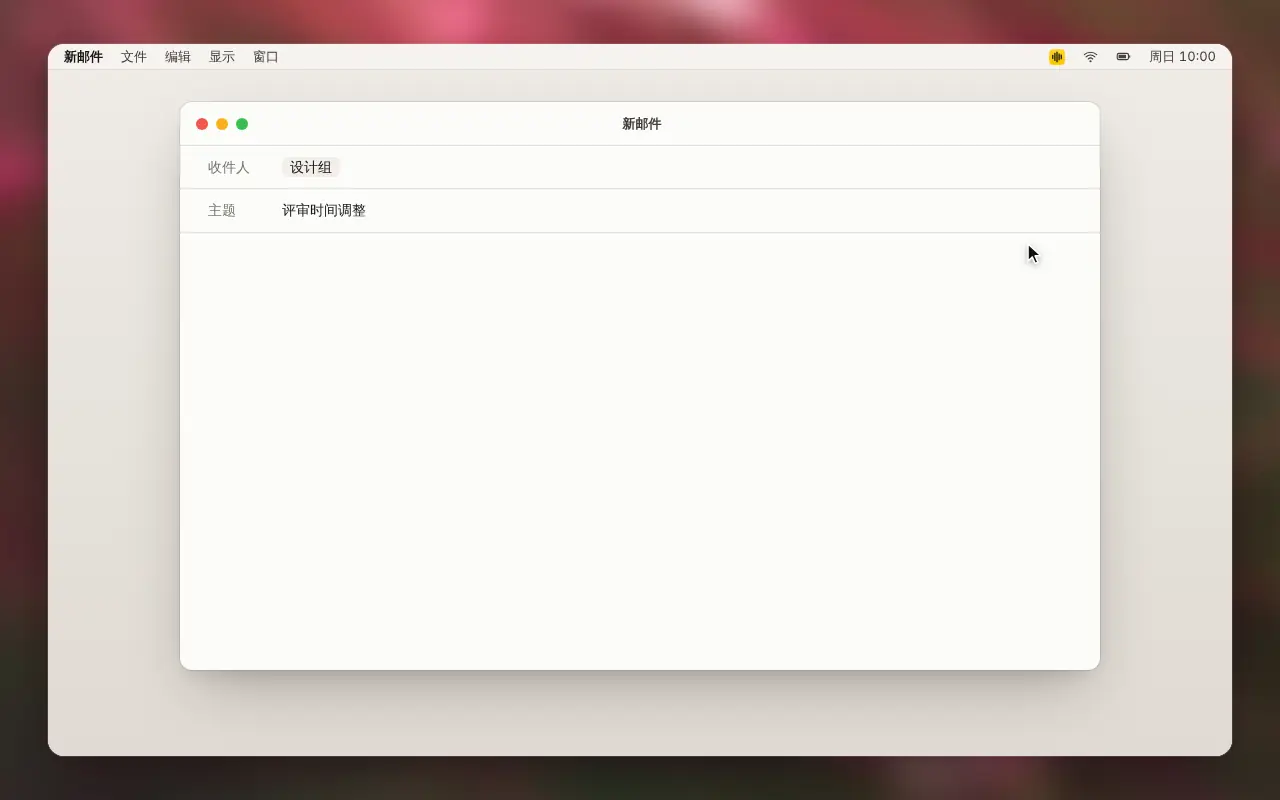
本地润色模型是 Qwen3.5-2B(Q4_K_M GGUF,约 1.3 GB),在 macOS 和 Windows 上通过 llama.cpp 运行。开启「按应用调整格式」后,Arion 会根据当前输入框类型、网页域名和应用标识,从聊天、邮件、工作消息、AI 提示词、搜索和列表六种场景里匹配版式。场景只调整版式而不改动原话,判断时也只看这些元数据,不读输入框里的正文。1
标点有四种模式:智能标点、完整标点、省略句末标点,以及中文界面下的「以空格代替标点」。你还可以允许润色参考光标附近和当前窗口里的文字,用来写对同音的人名和术语;这部分文字通过系统辅助功能接口读取并留在本机处理,不会截屏。2
早期版本曾在说话时实时刷新润色预览,但实测中松手后的最终润色总会覆盖预览,从没改变过最后上屏的文字。我们去掉了实时预览,把说话时的算力留给语音识别。3
如果你想用云端模型,可以登录 ChatGPT,或填入 OpenAI、Anthropic、Google Gemini、DeepSeek、OpenRouter 的 API Key。选好云端引擎、连接服务商并指定模型后,请求只发送识别出的文字、当前场景和命中的词库条目;音频、光标与窗口上下文、听写历史都留在本机。各服务商的 Key 在系统凭据库里独立存放,切换服务商不会互相覆盖。
换一个键,直接翻译
语音翻译有独立的快捷键:macOS 默认是右 Command,Windows 是右 Ctrl。按住它用中文说话,Arion 会先识别原文、修正同音词和专有名词,再输出目标语言的译文。
目标语言支持 12 种:English、简体中文、繁體中文、日本語、한국어、Español、Français、Deutsch、Português、Italiano、Русский 和 العربية。翻译与润色共用同一个本地或云端模型,关掉润色时照样可用。如果模型缺失、超时或输出未通过校验,胶囊会提示翻译失败并保持输入框原样,原文只留在当前会话内存里。手动修改译文不会触发纠错学习,避免外语拼写混进你的日常词库。
越用越准
词库按正确写法归类:每个词条列出常被误识的错误形式;安装了 Arion 输入法时,还能直接编辑该词的拼音读音。只填正确写法的词条会作为本地语音识别的热词,符合条件的纠错记录则会同时进入语音识别和拼音键盘词库。新词条排在最上方。
在 macOS 原生编辑器里,如果你动手改了 Arion 刚上屏的词,它会记下这次修改并在下次直接采用。
词库、学到的纠错和剪贴板历史在写入磁盘前都用 AES-256-GCM 加密。密钥在本机生成,macOS 上存入钥匙串,Windows 上由 DPAPI 保护。密钥缺失或校验失败时,Arion 会直接报错,不会退回明文保存。4
同一个输入法里的拼音键盘
Arion 自带离线的全拼输入法,在 macOS 上基于 IMK,在 Windows 上基于 TSF,两端共用同一套 Rime 方案、候选排序和学习逻辑。轻按 Shift 切换中英文,光标旁的标识随之翻转。macOS 的输入法菜单里还能切换全角字符和英文标点,或按 Ctrl . 切换标点。
候选排序会结合你刚打过的字。基础层记录最近 120 秒内在同一应用里连续上屏的前后词搭配,每次确认最多把候选往前提两位,防止一次手滑就占住首位。在 50 对同音词测试中,从第二次出现算起,单靠词频学习的首选命中率是 32.2%,加上前后词搭配后升至 88.7%。5
在此之上,可以在设置里打开两阶段本地神经排序:输入变化时,一个约 4.5 MB 的小模型先在 100 ms 预算内即时重排;停顿 150 ms 后,本地润色模型再结合光标前后和当前窗口的文字做二次重排,预算 900 ms。候选框始终先按默认顺序弹出,两个模型只调整现有候选的次序,不凭空造词。macOS 上通过辅助功能接口读取上下文,自动跳过密码框和拒绝名单里的应用;Windows 上目前只参考最近上屏的文字。6
中文模式下,键盘支持英文单词和前缀补全,也为完整拼音提供 Emoji 候选。你可以从八种预设颜色里挑选候选高亮色或自定义颜色;macOS 的输入法菜单里还带有一个「语音输入」入口,点一下即可开始听写。
剪贴板历史
剪贴板历史默认关闭。打开后会记录复制过的文字、链接、图片和文件引用。按 ⌘ ⇧ V(Windows 为 Ctrl Shift V)在光标旁呼出选择器,支持搜索、置顶,鼠标悬停在图片或长文本上可查看预览。按回车会把选中项粘贴回原输入框,没有焦点输入框时则复制到剪贴板。
复制文件时只存路径引用,不复制文件内容,也不记录文件夹。历史默认保留 200 条、共 100 MB,满了以后从最早的未置顶记录开始清理,不按时间过期。整个历史使用独立密钥加密;Arion 在听写上屏时临时借用剪贴板的内容不会计入历史。7
更新
更新包均使用 Ed25519 签名,安装前在本机校验。默认只接收稳定版;在「设置 › 关于」里打开「允许测试版更新」后才会收到预发布版本。自动检查和自动下载分开控制,自动下载默认关闭。下载好的更新会等你点击重启,不会打断正在进行的打字或听写。新版本提醒只在听写结束后的空闲时刻出现,可以延后或关闭,系统通知遵循操作系统的设置。
你的数据留在哪里
音频只在听写期间留在内存里,结束即释放,不会写成临时文件。诊断日志不包含识别草稿和润色结果。
Arion 没有云端语音识别。模型下载完成后,日常听写和拼音打字无需联网。应用只在下载模型、检查更新、使用你主动开启的云端润色,以及登录账户后拉取产品通知时发起网络请求。登录并明确同意后,Arion 会上报按天汇总的用量计数(日期、听写次数、麦克风时长和字数),不含录音、文字、场景或应用信息。详细的数据流向见《你的听写去了哪里》。
开始使用
在下载页选择你的平台。macOS 版需要 Apple 芯片与 macOS 14 及以上系统;Windows 版为 x64 安装包。首次启动时,引导流程会申请所需的系统权限,带你设置听写键、下载识别模型,并选择是否开启润色与语音翻译。
已经在用 alpha 版本的用户,可以在「设置 › 关于」里检查更新;如果没有收到 0.1.1,请从下载页手动覆盖安装一次。
从源码构建,clone 仓库后运行:
make install
make build desktop
还没做到的事
- 多设备同步还没有推出。加密边界已经写进规范(每条词库记录在上传前先在本机加密,中继服务只能看到密文),桌面端的设备注册尚未完成。
- 纠错学习目前只支持 macOS 原生编辑器。Windows 上可以手动维护词库。
- Windows 键盘的上下文排序目前只参考最近上屏的文字,还不读取光标和窗口内容。
- 英语和简体中文以外的 10 个翻译目标语言还没有独立的评测集,目前与英语共用校验规则。云端润色的质量和延迟也还没有基准测试。
- 不支持 Intel Mac(ADR 021)。
如果遇到问题,欢迎在 GitHub Issues 反馈,或加入 Discord 和飞书群。我们如何通过实验决定哪些改动上线,见《我们为什么像做实验一样做语音输入法》。
感谢所有在 alpha 阶段试用、反馈问题、录制复现步骤的用户与贡献者。
脚注
-
规范 009:上下文润色中的场景选择(
SCN-01、SCN-02)。 ↩ -
测试方法与结果见《我们为什么像做实验一样做语音输入法》中「同一次运行里同时测质量与延迟」一节。 ↩
-
ADR 036:两阶段本地键盘排序与 ADR 037。文中的 100 ms 和 900 ms 是配置的预算上限,对应的实际延迟还没有测量。 ↩